问题
检索与 OCR 结果并不总能形成可靠答案。如何利用多份文档中的有效证据,并理解文档噪声的影响?
从工业文档 OCR 鲁棒性到多文档证据分配,构建文档理解、检索与可信生成的评测和技术体系。
检索与 OCR 结果并不总能形成可靠答案。如何利用多份文档中的有效证据,并理解文档噪声的影响?
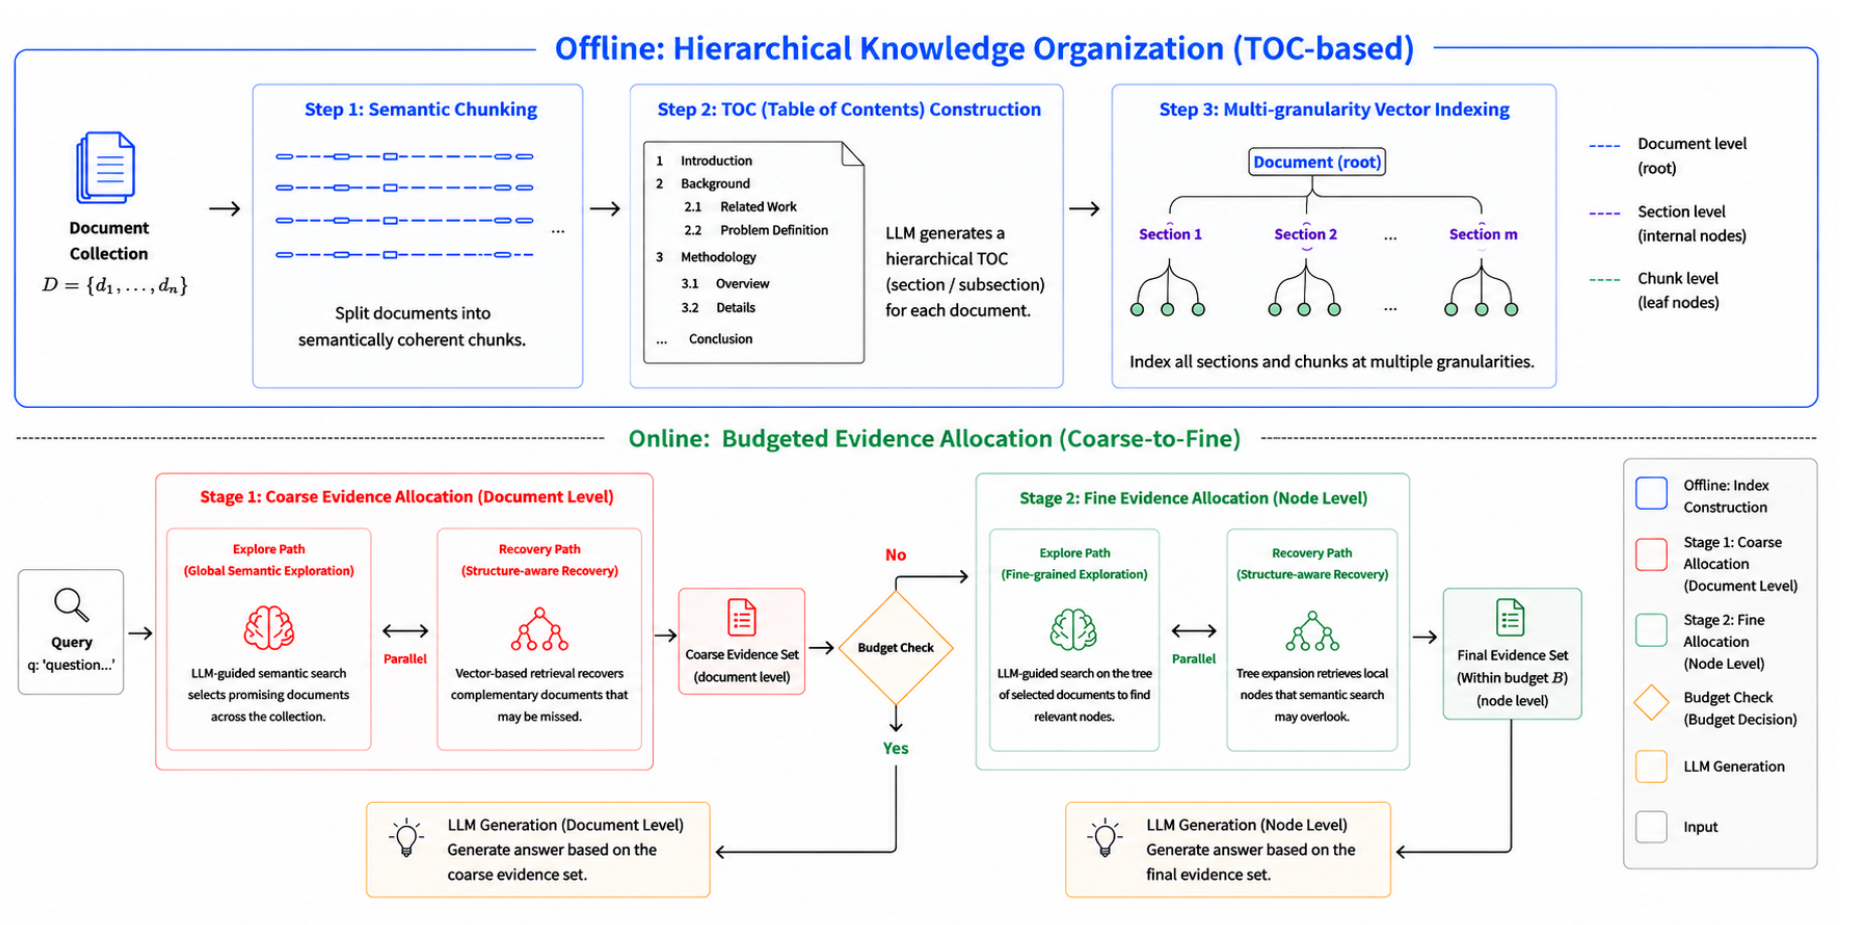
结合知识检索、文档结构、证据分配与生成评测。相关论文覆盖 OCR-RAG 鲁棒性、BEAR 多文档证据分配和 TextlessRAG 视觉文档问答。
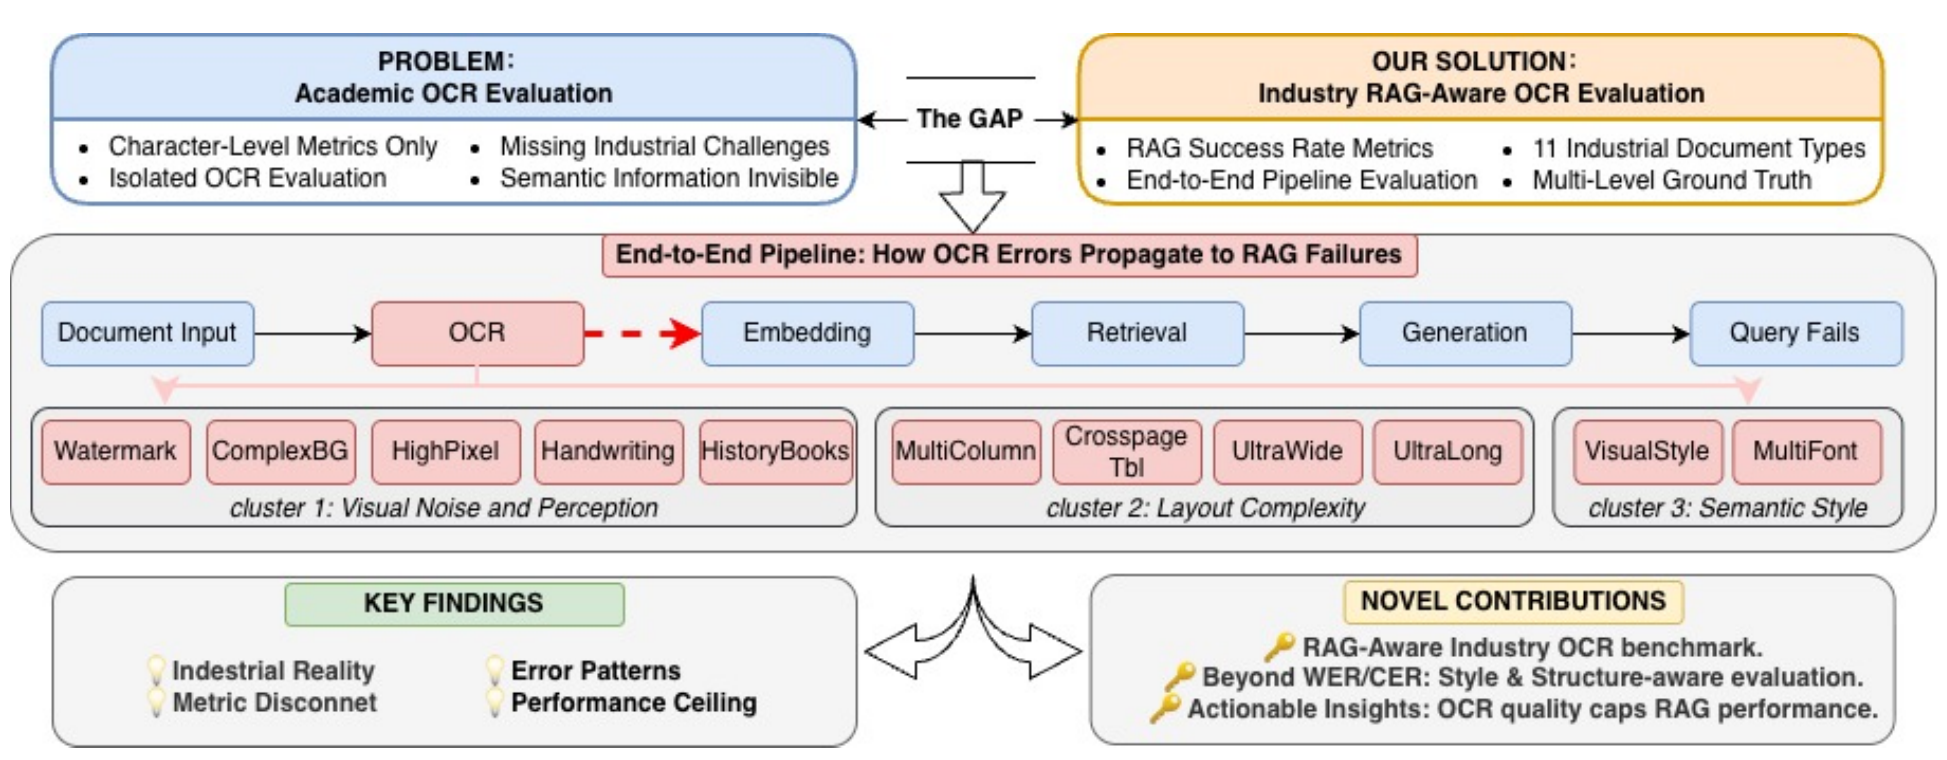
InduOCRBench 覆盖 12 个行业、570 份文档、3,402 页和 11 类挑战;BEAR 在统一生成器与证据预算下评估层次化检索和多文档推理。
视觉样式文档的 OCR 准确率为 82.9%,对应 RAG 准确率为 52.8%,相差 30.1 个百分点。以下为论文 Table 2 中十种方法在通用与工业文档基准上的综合指标(Avg)。
| OCR 方法 | OmniDocBench Avg ↑ | InduOCRBench Avg ↑ |
|---|---|---|
| PP-StructureV3 | 86.7 | 60.3 |
| MinerU2 | 75.5 | 66.5 |
| Doc2x | 84.6 | 61.6 |
| GPT-4o | 75.0 | 52.0 |
| Qwen3-VL-235B | 89.2 | 70.9 |
| Gemini-2.5 Pro | 88.0 | 74.5 |
| Deepseek-OCR | 87.0 | 61.5 |
| Hunyuan-OCR | 94.1 | 68.1 |
| MinerU2.5 | 90.7 | 72.5 |
| PaddleOCR-VL | 92.9 | 78.2 |
When Good OCR Is Not Enough · Table 2 / Figure 2 ↗
DragonBall 检索对比采用 Qwen3-32B 生成器,证据上下文在适用时按约 4K token 预算对齐;LongRefiner 使用不同的辅助模型。表列三次实验的均值 ± 标准差。BEAR(docs) 在 2Wiki 上的 EM/F1 为 34.63 ± 2.17 / 48.02 ± 1.45。
| 方法 | Recall % ↑ | Completeness % ↑ | Hallucination % ↓ | Irrelevance % ↓ |
|---|---|---|---|---|
| BM25 | 29.17 ± 1.06 | 35.13 ± 1.84 | 32.55 ± 2.40 | 32.25 ± 1.95 |
| BGE-M3 | 58.17 ± 1.91 | 59.56 ± 2.45 | 28.81 ± 2.26 | 11.54 ± 1.55 |
| RAPTOR | 31.93 ± 1.66 | 59.78 ± 2.70 | 26.50 ± 2.48 | 13.67 ± 1.29 |
| LongRefiner | 29.24 ± 2.32 | 43.86 ± 1.98 | 34.88 ± 2.25 | 21.26 ± 1.87 |
| HippoRAG2 | 68.80 ± 1.75 | 73.37 ± 2.24 | 19.55 ± 1.84 | 6.93 ± 0.93 |
| BEAR(docs) | 85.55 ± 0.47 | 91.86 ± 1.32 | 5.64 ± 1.02 | 2.40 ± 0.49 |
| BEAR(nodes) | 84.25 ± 0.84 | 88.64 ± 1.52 | 7.60 ± 1.12 | 3.71 ± 0.86 |